Le raisonnement comme orientation dans l’espace des jetons.
Il existe une vision intuitive mais simplifiée du raisonnement : laissez un modèle réfléchir plus longtemps et il aura plus de chances d’être correct. Cela correspond bien à notre intuition humaine : consacrez plus de temps et d’efforts à la réflexion et il est plus probable que nous parvenions à une réponse correcte.
Mais cette image ne semble pas tout expliquer. Au cours de la formation RL, les modèles apprennent à écrire des chaînes de pensée plus longues, et deviennent de plus en plus précis à mesure qu’ils le font. Pourtant, si vous prenez un modèle entraîné et forcez une chaîne à fonctionner plus longtemps, cela aide pendant un certain temps, puis cesse d’aider. Parfois, la réponse est même pirecomme si c’était trop réfléchir. Si une chaîne de pensée convergeait réellement vers un optimum, des étapes supplémentaires ne devraient pas aggraver la situation. Alors, est-ce vraiment la longueur de chaque chaîne qui aide au moment de l’inférence ? Ou est-ce quelque chose de plus subtil ?
Cet article est ma tentative de clarifier cette confusion (principalement pour moi-même) en considérant le raisonnement comme une recherche de chemin à travers l’espace symbolique. Nous verrons que RL maximise la probabilité de trouver un chemin de $x$ à $\Scal_x$, mais il n’est pas garanti que les chemins individuels convergent vers la bonne réponse. En prime, cette perspective clarifie certaines observations étranges sur les modèles de raisonnement, comme les chaînes de pensée infidèles et le piratage des récompenses.
Le raisonnement comme orientation
Posez dix fois à un modèle de raisonnement le même problème mathématique et vous obtiendrez dix chaînes de pensée différentes. Plutôt que de considérer le raisonnement comme un processus mystérieux menant à une réponse, considérons-le comme une recherche de chemin dans un espace symbolique. Il existe de nombreux chemins depuis le problème jusqu’à une réponse correcte, et le modèle en parcourt un avec chaque échantillon.
Considérez le problème : « qu’est-ce que $1 + 2 + 3 + \cdots + 10$ » ? Une solution consiste à additionner les nombres un par un : 1, 3, 6, 10, et ainsi de suite jusqu’à 55. Une autre façon consiste à les associer de l’extérieur vers l’intérieur : 1 $ + 10 $, 2 $ + 9 $, 3 $ + 8 $, 4 $ + 7 $ et 5 $ + 6 $ chacun font 11, et cinq paires de 11 font 55. Ces deux chemins aboutissent à la bonne réponse, 55.
Nous pouvons considérer le raisonnement comme suivant ce modèle général. On nous donne un point de départ, l’invite, que nous appellerons $x$. Nous voulons trouver un chemin $z$ qui commence à $x$ et se termine par une réponse correcte $y$. Pour savoir si un chemin atterrit au bon endroit, nous supposons que nous avons un vérificateur $r(x, y)$ qui renvoie 1 si $y$ est correct et 0 si ce n’est pas le cas.
Donc étant donné un point de départ $x$, nous voulons trouver un chemin de jetons $z$ qui atterrit dans l’ensemble
$$\Scal_x = \{y : r(x, y) = 1\}.$$
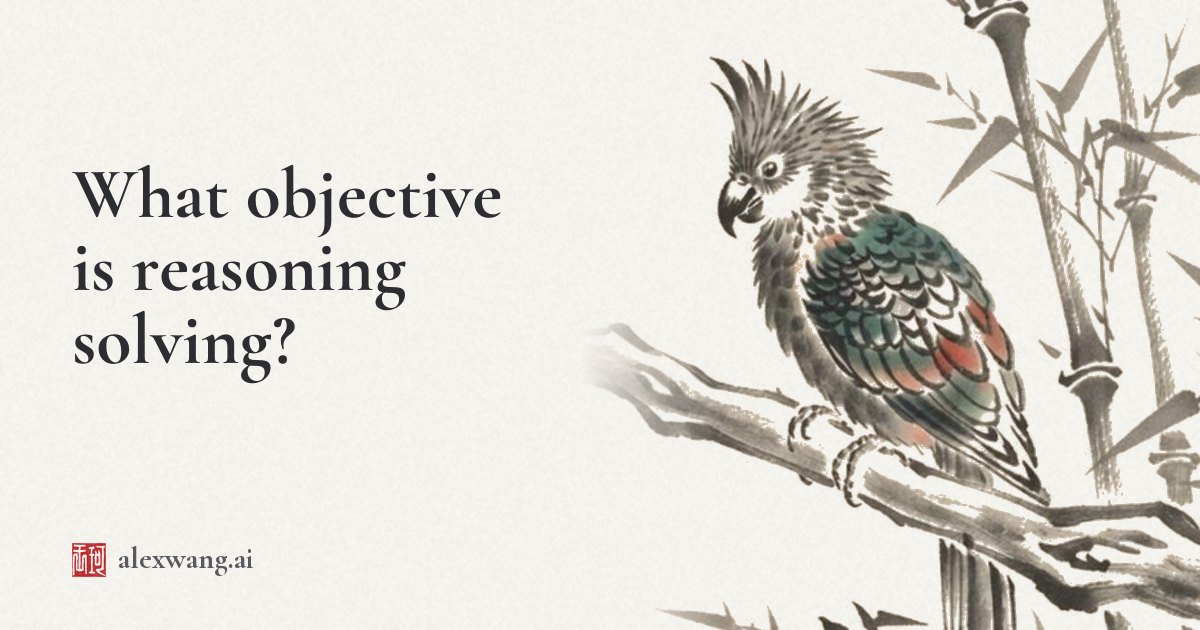
La figure en haut de cet article dessine cette image. Chaque ligne grise est un chemin échantillonné : elle part de l’invite de gauche, serpente dans l’espace des jetons en échantillonnant $z$, certains de ces chemins atterrissant dans $\Scal_x$.
Étant donné que de nombreux chemins aboutissent dans $\Scal_x$, la probabilité de succès s’additionne pour chacun d’eux. Soit $\pi(z \mid x)$ la probabilité que le modèle génère le chemin $z$ étant donné l’invite $x$, et $y(z)$ pour la réponse finale à la fin de $z$. La probabilité de succès est la probabilité de générer chaque chemin, multipliée par la probabilité que le chemin atterrisse dans $\Scal_x$, additionnée pour chaque chemin :
$$p_x = \prob{\text{un chemin arrive dans } \Scal_x \mid x} = \sum_{z} \underbrace{\pi(z \mid x)}_{\text{chemin des échantillons } z}\; \underbrace{\prob{y(z) \in \Scal_x \mid z}}_{\text{path } z \text{ atterrit dans }\Scal_x}.$$
Le deuxième facteur est juste 1 si le chemin atterrit dans $\Scal_x$ et 0 sinon, nous additionnons donc uniquement la probabilité que les chemins atterrissent dans $\Scal_x$ :
$$p_x = \sum_{z} \pi(z \mid x)\, \ind{y(z) \in \Scal_x} = \sum_{z \,:\, y(z) \in \Scal_x} \pi(z \mid x).$$
Nous appellerons $p_x$ le probabilité de réussite. Maximiser cette probabilité signifie que notre modèle sera plus susceptible d’échantillonner un chemin qui atterrit dans $\Scal_x$.
Notez qu’il existe deux manières d’augmenter cette probabilité. Soit le modèle peut échantillonner plusieurs chemins vers la même réponse, chacun avec une faible probabilité, soit le modèle peut échantillonner un seul chemin vers la réponse avec une très forte probabilité. La probabilité de succès ne se soucie pas de celui que nous obtenons, mais en pratique, nous pourrions vouloir donner la priorité à des chemins spécifiques ou garantir la diversité des échantillons..
Comment augmenter nos chances de succès ?#
Échantillonnage du meilleur des k$#
Le moyen le plus simple de rechercher un chemin est de demander au modèle $\pi$ de conserver les chemins d’échantillonnage $z$ jusqu’à ce que l’un d’entre eux atterrisse dans $\Scal_x$.
Puisque nous avons supposé que nous avions un vérificateur, nous pouvons effectuer un échantillonnage du meilleur des $k$, qui échantillonne les $k$ chemins et recherche un succès. Chaque chemin manque avec une probabilité $1 – p_x$, donc tous les $k$ manquent avec une probabilité $(1-p_x)^k$, et la probabilité de succès passe de $p_x$ à
$$\prob{\text{au moins un des } k \text{ chemins atterrit dans } \Scal_x \mid x} = 1 – \underbrace{(1-p_x)^k}_{\text{all } k \text{ chemins manqués}}.$$
Il s’agit d’un axe garanti de mise à l’échelle du calcul. Tant que $p_x > 0$, la probabilité de succès augmente de façon monotone à mesure que nous échantillonnons plus de chemins, donc dépenser plus de calcul sur plus d’échantillons est toujours utile, comme l’ont vu très tôt Brown et al. 2024. Cependant, la mise à l’échelle ici porte sur le nombre d’échantillons plutôt que sur la longueur des chemins (en pensant plus longtemps).
Entraîner le modèle pour générer de meilleurs échantillons#
Jusqu’à présent, le modèle a été corrigé, donc $p_x$ a également été corrigé. Pouvons-nous changer le modèle pour augmenter $p_x$ lui-même ?
Voici un moyen simple de procéder. Recueillez de nombreuses invites dont nous pouvons vérifier les réponses. Pour chacun d’entre eux, échantillonnez quelques chemins du modèle. Nous conservons les chemins qui atterrissent dans $\Scal_x$ et entraînons le modèle sur ceux que nous avons conservés. Puis répétez. À chaque tour, nous entraînons le modèle à accorder plus de poids aux chemins réussis qu’il a échantillonnés. Cette boucle est appelée réglage fin de l’échantillonnage par rejet, et STaR en était une première version pour le raisonnement.
RL avec une récompense vérifiable, qui est la façon dont les modèles de raisonnement d’aujourd’hui sont formés, s’avère faire presque la même chose. Soit $\pi_\theta$ le modèle avec des poids $\theta$. Alors puisque $r(x, y(z)) = 1$ exactement quand $y(z) \in \Scal_x$ :
$$ \begin{aligned} p_x &= \sum_{z \,:\, y(z) \in \Scal_x} \pi_\theta(z \mid x) \\ &= \sum_{z} \pi_\theta(z \mid x)\, \ind{y(z) \in \Scal_x} \\ &= \sum_{z} \pi_\theta(z \mid x)\, r(x, y(z)) \\ &= \ev[z \sim \pi_\theta(\cdot \mid x)]{r(x, y(z))}, \end{aligned} $$
ce qui signifie que la récompense binaire attendue est exactement la probabilité de succès $p_x$.
En calculant le gradient de la probabilité de succès via l’astuce de la dérivée logarithmique, nous arrivons à
$$\deg_\theta\, p_x = \ev[z \sim \pi_\theta(\cdot \mid x)]{r(x, y(z))\, \grad_\theta \log \pi_\theta(z \mid x)},$$
qui est exactement le gradient politique, également appelé estimateur REINFORCE. Estimez maintenant ce gradient avec $N$ chemins échantillonnés $z_1, \dots, z_N$. Les chemins qui ont échoué ont $r = 0$ et disparaissent, tandis que les chemins qui atterrissent dans $\Scal_x$ ont $r = 1$. Si $M$ des $N$ chemins réussissent, l’estimation est
$$\grad_\theta\, p_x \approx \frac{1}{N} \sum_{i \,:\, \text{landed}} \grad_\theta \log \pi_\theta(z_i \mid x) = \underbrace{\frac{M}{N}}_{\text{taux de réussite}} \cdot \underbrace{\frac{1}{M} \sum_{i \,:\, \text{landed}} \grad_\theta \log \pi_\theta(z_i \mid x)}_{\text{loger la probabilité des chemins réussis}}.$$
Ce gradient implique deux termes : le taux de réussite empirique $M/N$ et la probabilité logarithmique moyenne des chemins réussis.
En d’autres termes, une étape de REINFORCE avec une récompense binaire est une étape de réglage fin de l’échantillonnage de rejet sur les propres chemins échantillonnés du modèle, mis à l’échelle en fonction du taux de réussite actuel $M/N$.
Cela explique également la première observation de l’intro, selon laquelle les chaînes de pensée s’allongent pendant la formation RL. Chaque étape attire le modèle vers les chemins qui ont atterri, donc si les chemins qui ont réussi ont tendance à être plus longs que ceux qui ont échoué (par exemple parce qu’ils incluent un comportement de retour en arrière, recueillent plus de retours de l’environnement ou simplement par hasard), le modèle apprendra à écrire des chemins plus longs.
Amortissement et généralisation#
Pendant la formation RL, nous dépensons beaucoup de calcul pour rechercher de bons chemins, puis nous entraînons le modèle pour générer ces chemins directement. Une fois entraîné, le modèle peut produire la réponse sans dépenser tout ce calcul supplémentaire pour échantillonner plusieurs chemins. Ceci s’appelle amortir la recherche : nous la payons une fois pendant la formation, nous n’avons donc pas à la payer à chaque fois que nous posons une question au modèle. Puisque nous formons un modèle unique à de nombreuses invites, le modèle peut potentiellement généraliser à de nouvelles invites qu’il n’a jamais vues.
La figure ci-dessous montre cela pour quatre invites, chacune avec son propre $\Scal_x$, et bascule entre le modèle avant et après l’entraînement. Pendant la formation, nous échantillonnons les chemins de chaque invite, conservons ceux qui réussissent et SFT dessus. Les pourcentages montrent le taux de réussite empirique donné à chaque invite. L’invite creuse est nouvelle et n’a jamais été vue par le modèle, mais le modèle se généralise à cette nouvelle invite après l’entraînement. À mesure que la nouvelle invite s’éloigne de la distribution d’entraînement, sa précision diminue (essayez de la faire glisser !).
Revisiter quelques observations sur le raisonnement#
Une fois que nous voyons un modèle de raisonnement comme une distribution entraînée pour atterrir dans $\Scal_x$ étant donné n’importe quel $x$, quelques faits étranges sur ces modèles deviennent clairs.
Il n’est pas garanti que les chaînes de pensée soient fidèles#
Notre vérificateur ci-dessus vérifie uniquement si la réponse est correcte. La récompense est de 1 si $y(z) \in \Scal_x$ et de 0 sinon, donc les jetons intermédiaires $z$ ne sont qu’un moyen pour le modèle d’accéder à la réponse. Rien n’exige que ces jetons soient vrais ou qu’ils expliquent la réponse qui suit, même si, bien sûr, ils sont souvent corrélés en raison du pré-entraînement du modèle.
Si nous voulons des chaînes de réflexion significatives, nous devons ajuster les récompenses ou l’objectif de formation.
Le piratage des récompenses provient à la fois du vérificateur et de l’échantillonneur#
Nous avons également supposé que le vérificateur ne se trompe jamais, que $r(x, y)=1$ si et seulement si $y$ est réellement la bonne réponse à $x$. Mais en pratique, le vérificateur peut être imparfait. Alors $\Scal_x$, l’ensemble des réponses acceptées par le vérificateur, n’est pas le même que l’ensemble des bonnes réponses : il peut inclure de mauvaises réponses et laisser de côté les bonnes. Cette mauvaise spécification ouvre des régions de $\Scal_x$ dans lesquelles le modèle pourrait apprendre à atterrir même si ce n’est pas ce que nous voulions.
Ainsi, le piratage des récompenses provient d’un vérificateur imparfait, qui ne parvient pas à capturer ce que nous voulons réellement, ainsi que d’une procédure d’échantillonnage imparfaite qui ne parvient pas à rester à l’écart de ces régions de raccourci.
Dans la figure ci-dessous, le cercle pointillé représente l’ensemble des réponses correctes et l’ellipse rouge est $\Scal_x$. L’ellipse s’étend vers l’invite, donc ses mauvaises réponses sont les plus faciles à atteindre, et après l’entraînement, la plupart des chemins y atterrissent.
Cette visualisation montre également pourquoi la mise à l’échelle du RL (générant plus d’échantillons et des échantillons plus longs) rend le piratage de récompense plus probable. Plus nous « fuzzons » le vérificateur, plus nous avons de chances de trouver un chemin qui atterrit dans la région mal spécifiée de $\Scal_x$. Une fois que le modèle a trouvé ce raccourci, l’entraînement le pousse vers un comportement similaire.
Alors, quel objectif le raisonnement résout-il ?#
Le raisonnement ne résout en réalité aucun objectif. Il n’est pas garanti qu’un chemin converge vers la bonne réponse. Ce n’est que globalement, selon la répartition des chemins, que nous obtenons une forte probabilité de succès.
La formation RL augmente directement la probabilité de succès $p_x$, en consacrant beaucoup de calculs à la recherche de chemins réussis, puis en entraînant le modèle pour les reproduire. Les gains que nous attribuons au fait de « penser plus longtemps » proviennent de la recherche que nous avons payée pendant la formation, plutôt que de l’inférence. Des chaînes de pensées plus longues ont tendance à être corrélées au succès lors de la formation, qui est ensuite entraînée dans le modèle. Le coût de l’échantillonnage est amorti dans les poids, donc au moment de l’inférence, le modèle est susceptible de réussir avec un seul échantillon, mais la réussite d’un échantillon individuel n’est pas garantie.